Module 16 – Métadonnées
Ce module portera sur les métadonnées.
Ce module portera sur les métadonnées.
Dans notre module précédent, nous avons :
Nous avons abordé le sujet des vocabulaires contrôlés. Les vocabulaires contrôlés contribuent à la normalisation des données, ce qui va de pair avec l'utilisation de métadonnées standard ou de métadonnées respectant un schéma de métadonnées.
Les métadonnées, ce sont des données sur les données ! Ça peut paraître un peu compliqué, on le sait, mais pour faire simple, les métadonnées sont les mots qu'on utilise pour décrire les données.
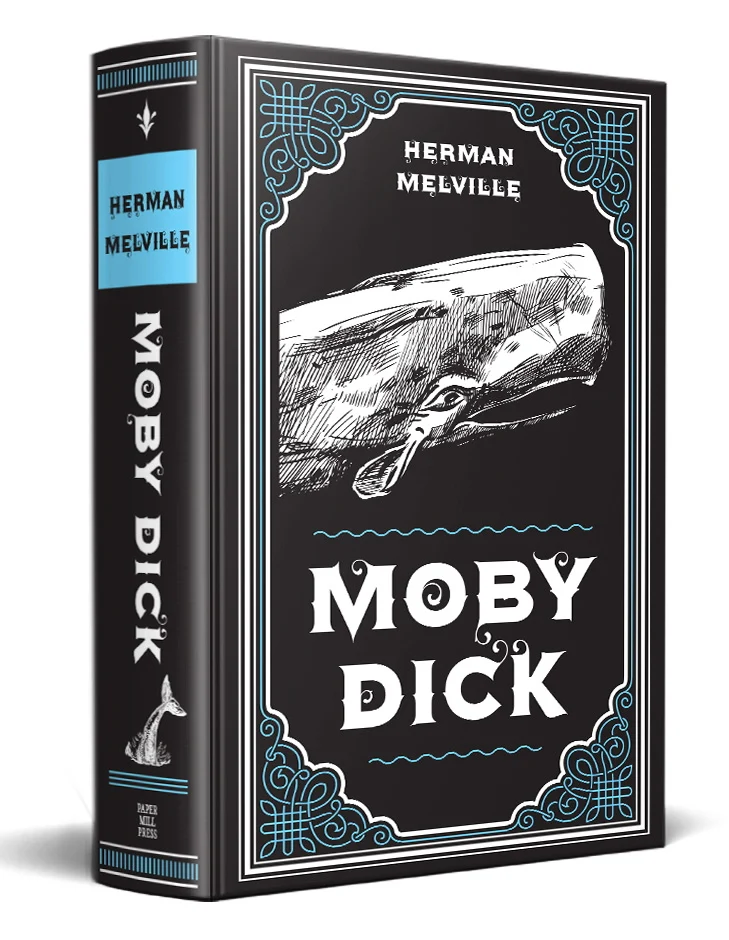
Cet ouvrage contient de nombreuses informations qu'il convient de classer. Par exemple : le titre de l'ouvrage, les numéros de page, l'auteur, la maison d'édition, la date de première publication, etc.
En tant qu’être humain, vous pouvez regarder ce livre et comprendre, d’après le contexte, qui l’a écrit et quel est son titre, simplement parce que vous savez ce qu’est un livre et comment il est généralement présenté. Vous voyez les mots « écrit par » et vous comprenez qui est l’auteur. Mais les machines sont incapables d'analyser ce contexte à moins que nous ne leur fournissions les règles pour le faire. Il ne suffit pas de simplement entrer les mots « Moby Dick » et « Herman Melville » dans une machine ; celle-ci a besoin de normes pour pouvoir donner un sens à ces informations.
C'est là qu'intervient le schéma de métadonnées, car il décrit de manière précise quelles informations sont requises, afin que les machines puissent les comprendre.
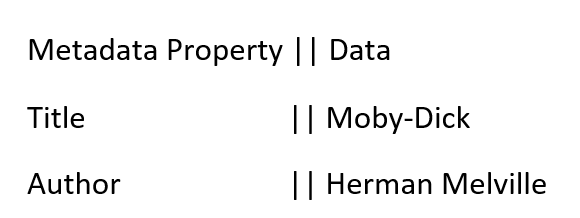
Les propriétés de métadonnées décrites ici sont le titre du livre et l'auteur. Les métadonnées proprement dites associées à ces propriétés sont respectivement « Moby Dick » et « Herman Melville ». Ce type de métadonnées sur le livre permet de classer et d'organiser correctement les livres (les données) d'une bibliothèque au sein d'un catalogue, où ils peuvent faire l'objet de recherches et être facilement retrouvés.
Grâce à ces métadonnées, vous pourriez utiliser un filtre dans un catalogue permettant de rechercher des livres uniquement par titre ou uniquement par auteur. En effet, ces métadonnées permettent à une machine de distinguer la partie du livre qui correspond au titre de celle qui correspond à l’auteur. Cela rend vos données plus FAIRen les rendant « trouvables » par les machines sur le Web.
Les schémas de métadonnées sont essentiellement des listes de questions auxquelles vous répondez pour vous aider à mettre vos métadonnées en conformité avec une norme ou un standard. C'est particulièrement vrai si un schéma de métadonnées a déjà été choisi par votre bailleur de fonds, ou si le dépôt que vous avez sélectionné pour votre soumission impose un schéma standard. Pensez à passer en revue les exigences de votre schéma de métadonnées avant même de commencer vos travaux de recherche. Savoir quelles métadonnées vous devez renseigner vous permettra de vous sentir plus à l'aise tout au long du projet, car vous saurez d'emblée quelles informations concernant vos données vous devez enregistrer, et lesquelles ne le sont pas.
Maintenant que vous avez une idée générale de ce que sont les métadonnées, la prochaine leçon abordera plus en détail les schémas de métadonnées normalisés. Il s'agit de structures de métadonnées spécifiques qui varient en fonction du type de données qu'elles décrivent. Les schémas de métadonnées sont souvent créés à partir des éléments jugés les plus importants.
Parmi les plus courants, on trouveDublin Core etMDOS (Metadata Object Description Schema), qui sont tous deux des schémas généraux. Il existe de nombreux schémas scientifiques, qui sont regroupés par catégorie, notamment les sciences sociales ou les sciences biologiques, etc.
L'un des formats les plus courants, dont vous avez peut-être déjà entendu parler, est Darwin Core. Darwin Core est une extension de Dublin Core, axée sur la biodiversité et les sciences naturelles. Il existe également leConventions relatives aux métadonnées climatiques et de prévisions (CF), que nous avons évoquées dans certains de nos autres modules, ainsi que leLangage de métadonnées écologiques (EML). L’EML est une syntaxe de balisage XML utilisée dans les sciences de la Terre et de l’environnement ; son utilisation dans d’autres disciplines de recherche ne cesse de se développer. Les métadonnées CF portent sur les propriétés spatiales et temporelles des données climatiques et de prévision. Les propriétés spatiales et temporelles sont, comme mentionné précédemment, des propriétés géographiques, car toutes les données océaniques sont de nature géographique.
Voici un exemple illustrant quelquesTermes Darwin Core et ce qu'il faudrait indiquer dans les champs :
| Étiquette | Nom de l'organisme |
| Définition | Nom ou libellé attribué à une instance d’organisme. |
| Exemples | Huberta, L'arbre-prison de Boab, Le groupe J |
| Étiquette | Organisme Remarques |
| Définition | Commentaires ou remarques concernant l'instance « Organisme ». |
| Exemples | L'un des six chiots de la portée |
Comme vous pouvez le constater à partir de ces exemples, les termes Darwin Core permettent d'étiqueter et de partager facilement des données biologiques. Le fait de suivre un schéma évite toute controverse sur les définitions et évite de perdre du temps à déterminer où classer chaque donnée ou comment la nommer, comme ce serait le cas si vous deviez créer votre propre schéma.
Comprendre les métadonnées et le rôle qu'elles jouent dans votre projet de recherche vous permettra de mener celui-ci plus efficacement et plus facilement.
Dans notre prochain module, nous verrons comment traduire un schéma de métadonnées vers un autre.
Si vous deviez organiser une collection ou un ensemble d'objets dans votre chambre, quelles propriétés souhaiteriez-vous voir figurer dans leur schéma de métadonnées ? Imaginez que votre collection compte une centaine d'objets uniques, voire un millier ! Quel schéma utiliseriez-vous pour vous assurer qu'il soit facile de retrouver ces objets à l'aide d'un ordinateur ou d'un moteur de recherche ?